Whisper Transcription คือการใช้ Whisper โมเดลรู้จำเสียงพูดแบบอเนกประสงค์ (general-purpose speech recognition model) ของ OpenAI ถอดเสียงสัมภาษณ์หรือพอดแคสต์เป็นข้อความ ผู้ใช้ติดตั้งผ่านโครงการเปิดบน GitHub แล้วสั่งถอดเสียงด้วยคำสั่งเดียวได้ แต่ผลจะแม่นแค่ไหนขึ้นกับภาษาและขนาดโมเดลที่เลือก นักข่าวและครีเอเตอร์จึงควรรู้ข้อจำกัดก่อนนำไปใช้งานจริง
ผู้พัฒนาอธิบายไว้ในหน้าโครงการบน GitHub ว่า Whisper ถูกฝึกด้วยข้อมูลเสียงที่หลากหลายชุดใหญ่ และเป็นโมเดลที่ทำได้หลายงานในตัวเดียว ได้แก่ รู้จำเสียงพูดหลายภาษา แปลเสียงพูด และระบุว่าเสียงที่ได้ยินเป็นภาษาอะไร
Whisper Transcription ทำงานอย่างไรและทำอะไรได้บ้าง
Whisper ใช้โมเดลแบบ Transformer sequence-to-sequence ที่ฝึกกับงานด้านเสียงหลายอย่างพร้อมกัน เช่น รู้จำเสียงพูดหลายภาษา แปลเสียงพูด ระบุภาษาของเสียง และตรวจจับช่วงที่มีเสียงพูด งานเหล่านี้ถูกแทนด้วยลำดับโทเคน (token) ชุดเดียวกัน ทำให้โมเดลตัวเดียวแทนขั้นตอนหลายขั้นของระบบประมวลผลเสียงแบบเดิมได้
สำหรับผู้ใช้ทั่วไป ความหมายคือไม่ต้องต่อเครื่องมือหลายตัวเพื่อถอดเสียงและแปลภาษา แต่ต้องรู้ว่าโมเดลบางขนาดไม่ได้ทำทุกงาน โมเดล turbo ซึ่งเป็นค่าเริ่มต้นของคำสั่งถอดเสียง ไม่ได้ฝึกมาสำหรับงานแปล ถ้าต้องการแปลเสียงที่ไม่ใช่ภาษาอังกฤษเป็นภาษาอังกฤษ ให้เลือกโมเดลหลายภาษาตัวอื่นแทน ได้แก่ tiny, base, small, medium หรือ large
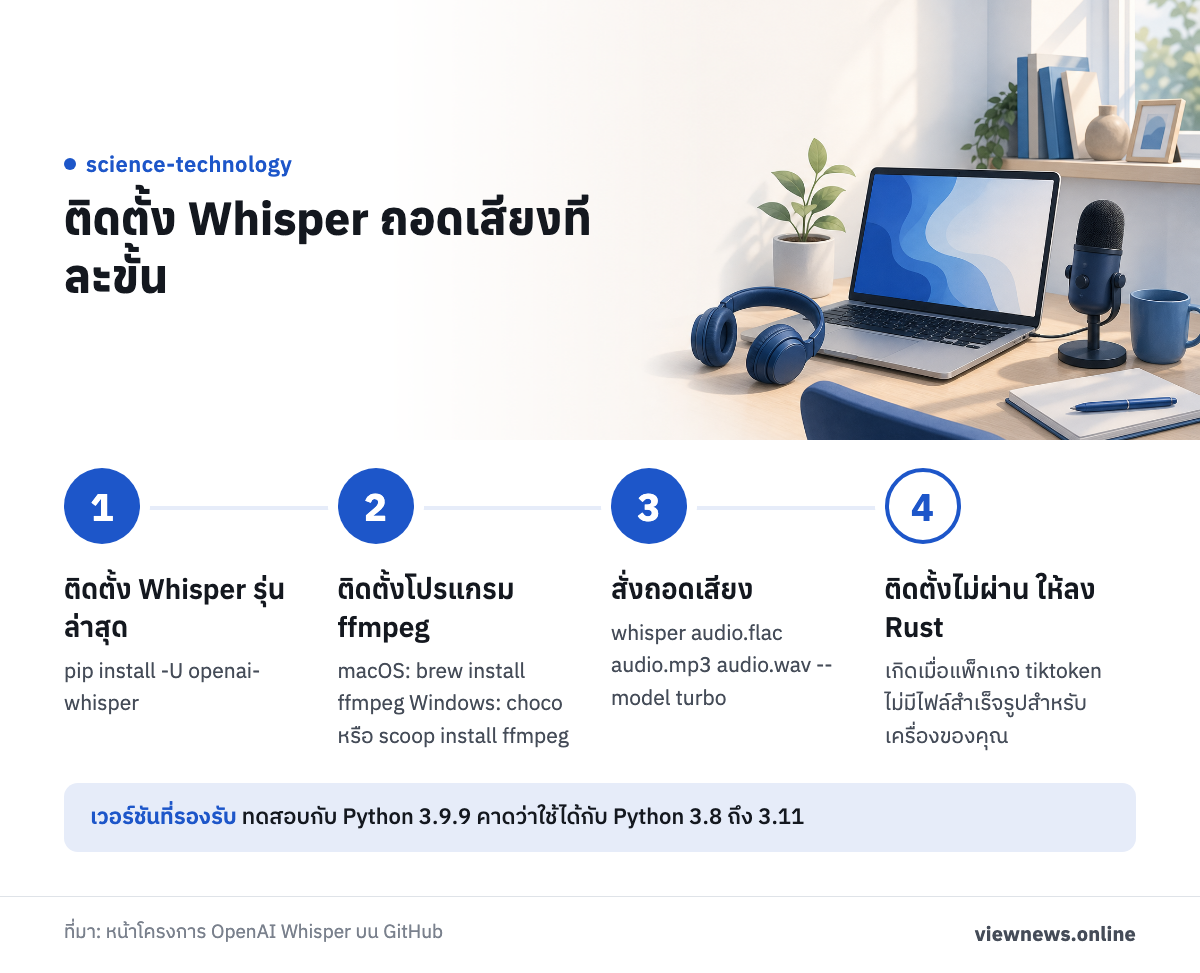
ติดตั้งและสั่งถอดเสียงทีละขั้น
ทีมผู้พัฒนาฝึกและทดสอบโมเดลด้วย Python 3.9.9 และ PyTorch 1.10.1 แต่คาดว่าโค้ดใช้ได้กับ Python 3.8 ถึง 3.11 และ PyTorch รุ่นใหม่ๆ ขั้นตอนพื้นฐานมีดังนี้
- ติดตั้งหรืออัปเดต Whisper รุ่นล่าสุดด้วยคำสั่ง pip install -U openai-whisper
- ติดตั้งโปรแกรม ffmpeg ที่ Whisper ต้องใช้ บน macOS ใช้ brew install ffmpeg บน Windows ใช้ choco install ffmpeg หรือ scoop install ffmpeg
- ถ้าติดตั้งไม่ผ่านเพราะแพ็กเกจ tiktoken ไม่มีไฟล์สำเร็จรูปสำหรับเครื่องของคุณ ให้ติดตั้ง Rust เพิ่ม
- สั่งถอดเสียงด้วยคำสั่ง whisper audio.flac audio.mp3 audio.wav --model turbo
คำสั่งสุดท้ายแสดงว่าสั่งถอดหลายไฟล์พร้อมกันได้ในบรรทัดเดียว ตัวอย่างในโครงการใช้ไฟล์ .flac, .mp3 และ .wav ส่วนค่าเริ่มต้นของคำสั่งคือโมเดล turbo ที่ผู้พัฒนาระบุว่าใช้ถอดเสียงภาษาอังกฤษได้ดี
ถ้าเจอข้อความแจ้งว่าไม่มีโมดูล setuptools_rust ให้ติดตั้งด้วยคำสั่ง pip install setuptools-rust และบางเครื่องอาจต้องตั้งค่าตัวแปร PATH ให้เห็นโฟลเดอร์ของ Rust ด้วย
เลือกโมเดลให้เหมาะกับเครื่องและงาน
Whisper มีโมเดล 6 ขนาด โดย 4 ขนาดมีรุ่นสำหรับภาษาอังกฤษอย่างเดียวด้วย แต่ละขนาดแลกกันระหว่างความเร็วกับความแม่นยำ และยิ่งใหญ่ยิ่งใช้หน่วยความจำการ์ดจอ (VRAM) มาก ตัวเลขความเร็วเทียบกับโมเดล large และวัดจากการถอดเสียงภาษาอังกฤษบนการ์ด A100 ผลบนเครื่องของคุณอาจต่างไปมากตามภาษา ความเร็วในการพูด และฮาร์ดแวร์ ตัวเลขโดยประมาณของแต่ละขนาดเป็นดังนี้
- tiny มี 39 ล้านพารามิเตอร์ ใช้ VRAM ราว 1 GB และเร็วราว 10 เท่า
- base มี 74 ล้านพารามิเตอร์ ใช้ VRAM ราว 1 GB และเร็วราว 7 เท่า
- small มี 244 ล้านพารามิเตอร์ ใช้ VRAM ราว 2 GB และเร็วราว 4 เท่า
- medium มี 769 ล้านพารามิเตอร์ ใช้ VRAM ราว 5 GB และเร็วราว 2 เท่า
- large มี 1,550 ล้านพารามิเตอร์ ใช้ VRAM ราว 10 GB เป็นฐานเปรียบเทียบที่ 1 เท่า
- turbo มี 809 ล้านพารามิเตอร์ ใช้ VRAM ราว 6 GB และเร็วราว 8 เท่า
โมเดล turbo เป็นรุ่น large-v3 ที่ปรับให้ถอดเสียงเร็วขึ้น โดยความแม่นยำลดลงน้อยมาก ส่วนโมเดล tiny, base, small และ medium มีรุ่น .en สำหรับงานภาษาอังกฤษอย่างเดียว ซึ่งมักทำได้ดีกว่า โดยเฉพาะ tiny.en และ base.en ส่วนความต่างจะน้อยลงในรุ่น small.en และ medium.en งานภาษาไทยจึงต้องใช้โมเดลหลายภาษา ไม่ใช่รุ่น .en
ภาษาไทยแม่นแค่ไหน และต้องตรวจอะไรก่อนใช้งาน
ประสิทธิภาพของ Whisper ต่างกันมากตามภาษา ผู้พัฒนาวัดด้วยอัตราคำผิด (WER) หรืออัตราตัวอักษรผิด (CER) บนชุดข้อมูล Common Voice 15 และ Fleurs ของโมเดล large-v3 และ large-v2 แล้วแสดงเป็นกราฟแยกตามภาษา ตัวเลขของโมเดลอื่นและชุดข้อมูลอื่นอยู่ในภาคผนวก D.1, D.2 และ D.4 ของงานวิจัยที่ผู้พัฒนาเผยแพร่ ใครอยากรู้ผลของภาษาไทยโดยเฉพาะควรเปิดดูที่นั่น
หน้าโครงการไม่ได้แสดงตัวเลขความแม่นยำภาษาไทยไว้ในส่วนที่อธิบายผลต่อภาษา จึงไม่ควรถือว่าผลถอดเสียงภาษาไทยถูกต้องครบถ้วน นักข่าวควรฟังเสียงต้นฉบับเทียบกับข้อความทุกครั้ง โดยเฉพาะชื่อคน ตัวเลข และคำที่จะนำไปอ้างเป็นคำพูด เพราะคำผิดเพียงคำเดียวอาจเปลี่ยนความหมายของข่าวได้
วิธีที่ปลอดภัยที่สุดคือลองหลายขนาดกับไฟล์ตัวอย่างสั้นๆ ที่เป็นเสียงจริงของงานตัวเอง เช่น turbo เทียบกับ small หรือ medium แล้วเปรียบเทียบข้อความที่ได้กับเสียงต้นฉบับ จากนั้นเลือกขนาดที่ให้ผลน่าพอใจและเครื่องรันไหว โมเดลที่ใหญ่ขึ้นใช้ทรัพยากรเครื่องมากขึ้นและช้าลง ผู้ใช้จึงควรชั่งน้ำหนักด้วยผลทดลองของตัวเอง ไม่ใช่ตัดสินจากขนาดอย่างเดียว
ที่มา: หน้าโครงการ OpenAI Whisper บน GitHub (github.com/openai/whisper)