วิธีป้องกัน AI ดึงข้อมูลเว็บไปฝึกโมเดลเริ่มได้จากไฟล์ robots.txt ซึ่งใช้บอกบอทว่าห้ามเข้าส่วนไหนของเว็บ เจ้าของเว็บไซต์ นักเขียน และช่างภาพที่ไม่อยากให้ผลงานถูกบริษัท AI นำไปใช้ ทำต่อได้ด้วยการตั้งค่าเฉพาะบอทของ OpenAI และ Google และใช้บริการคุมทราฟฟิกอย่าง Cloudflare วิธีเหล่านี้ลดความเสี่ยงได้ แต่ยังไม่มีวิธีไหนรับประกันว่าจะกันได้ทุกบอท
robots.txt ด่านแรกที่ทำได้ทันที
robots.txt คือไฟล์ข้อความที่บอกบอทของเว็บค้นหาว่าเข้าถึง URL ไหนในเว็บของคุณได้ ตามคู่มือของ Google ไฟล์นี้ใช้จัดการปริมาณการเข้าเว็บของบอทเป็นหลัก ไม่ได้ออกแบบมาซ่อนหน้าเว็บ ต้องวางไว้ที่รากของโดเมน เช่น https://www.example.com/robots.txt วางในโฟลเดอร์ย่อยไม่ได้ และต้องตั้งชื่อว่า robots.txt เท่านั้น
จุดที่ต้องรู้คือไฟล์นี้บังคับบอทไม่ได้ Google ระบุว่าคำสั่งใน robots.txt ไม่สามารถบังคับพฤติกรรมของบอทได้ และบอทบางตัวอาจไม่ทำตาม ดังนั้นต้องมองว่าเป็นการแจ้งความประสงค์ที่บอทของบริษัทใหญ่ซึ่งประกาศว่าจะเคารพกติกานี้จะทำตาม ไม่ใช่กำแพงที่กันได้ทุกคน
ข้อควรระวังคือถ้าสั่ง Disallow: / กับทุกบอท เว็บอาจหายจากผลค้นหาด้วย เพราะคู่มือของ Google ใช้คำสั่งนี้เพื่อบล็อก Googlebot ทั้งเว็บ จึงควรระบุชื่อบอทที่ต้องการบล็อกเป็นรายตัว
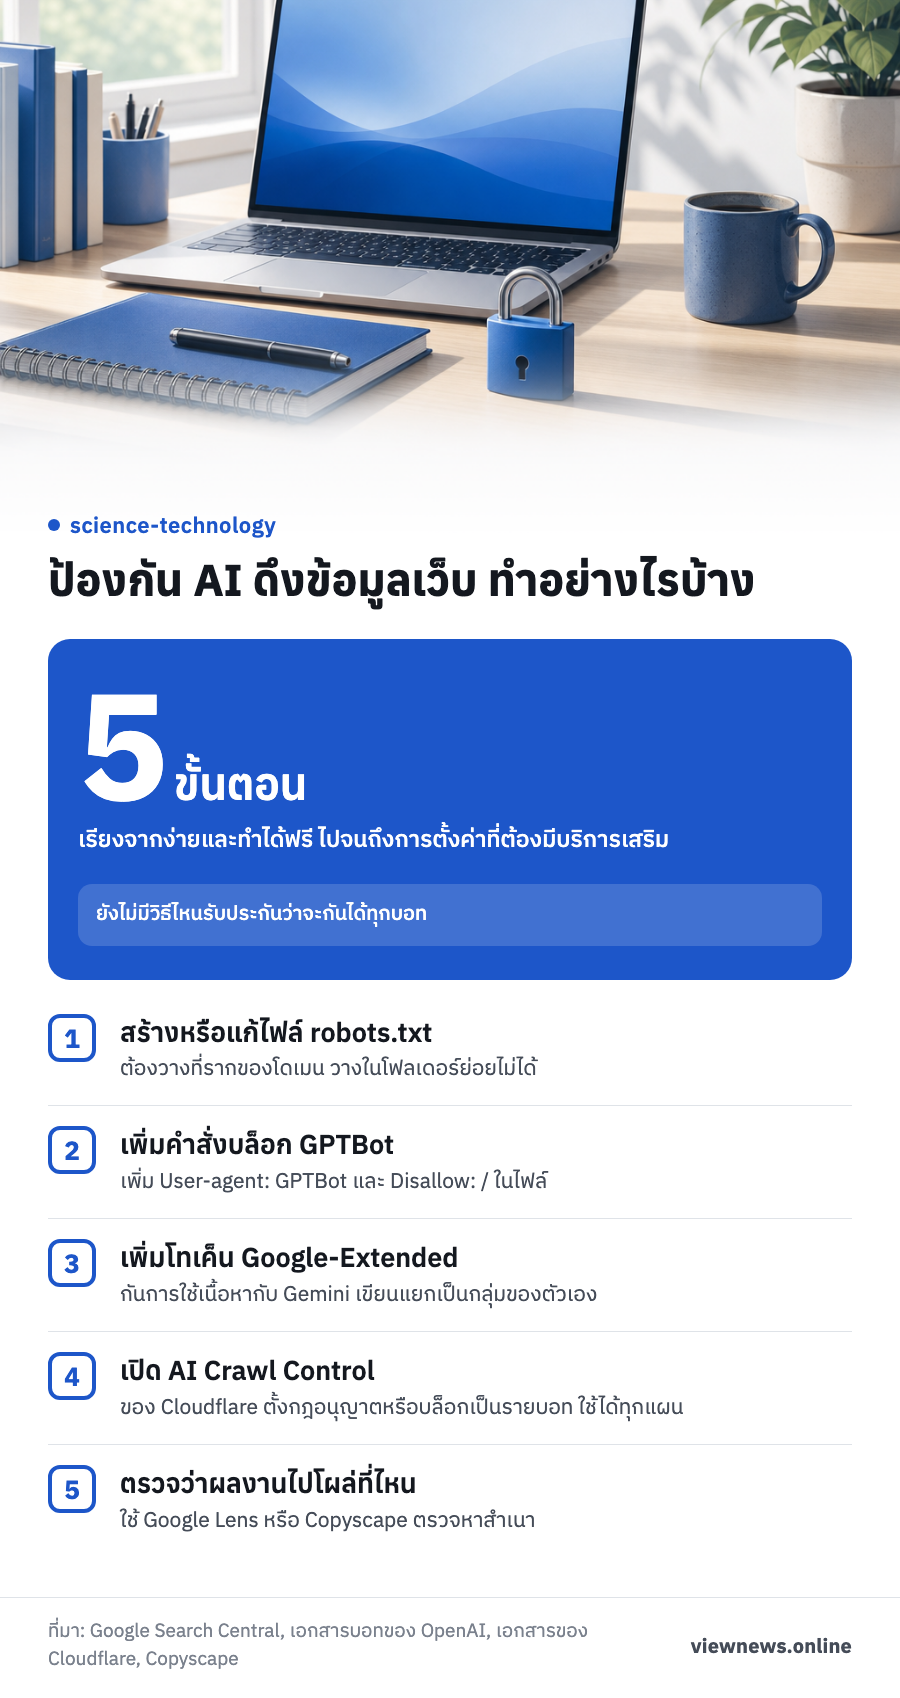
ป้องกัน AI ดึงข้อมูลเว็บใน 5 ขั้นตอน
ลำดับต่อไปนี้เรียงจากง่ายและทำได้ฟรี ไปจนถึงการตั้งค่าที่ต้องมีบริการเสริม
- สร้างหรือแก้ไฟล์ robots.txt ที่รากของโดเมน
- เพิ่มคำสั่งบล็อก GPTBot ของ OpenAI เพื่อไม่ให้เนื้อหาถูกใช้ฝึกโมเดล
- เพิ่มโทเค็น Google-Extended เพื่อกันการใช้เนื้อหากับ Gemini
- เปิดการจัดการบอท AI ที่ชั้นเครือข่าย เช่น AI Crawl Control ของ Cloudflare
- ตรวจเป็นระยะว่าผลงานของคุณไปโผล่ที่ไหน
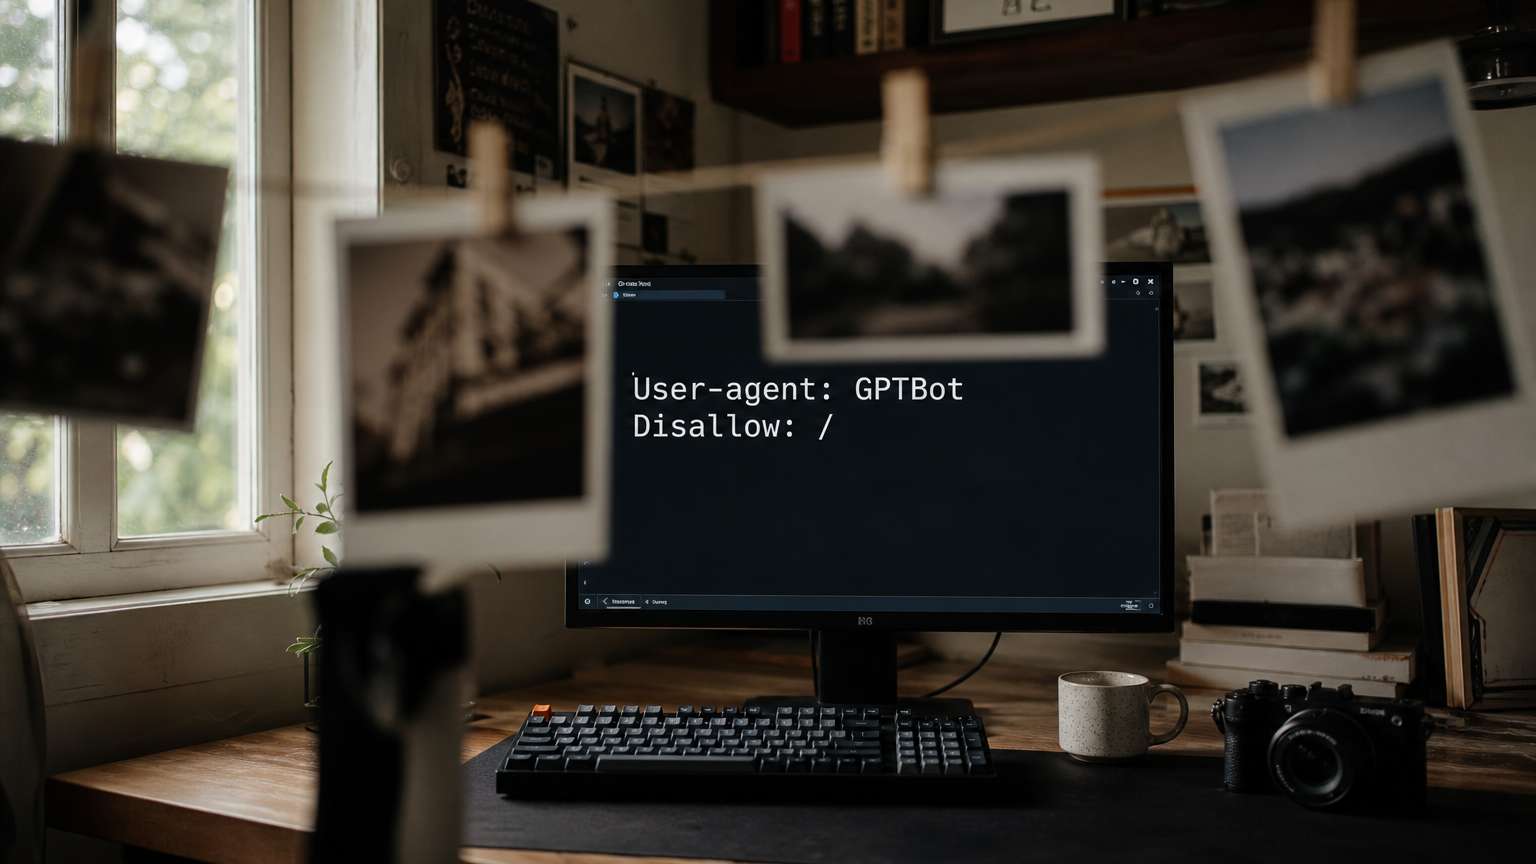
ขั้นตอนที่ 1 และ 2 ทำพร้อมกันได้ในไฟล์เดียว ถ้าต้องการกัน GPTBot ให้เพิ่มสองบรรทัดคือ User-agent: GPTBot และ Disallow: / ตามเอกสารของ OpenAI การห้าม GPTBot หมายถึงเนื้อหาของเว็บไม่ควรถูกใช้ฝึกโมเดล AI พื้นฐานเชิงสร้างสรรค์ของบริษัท
ขั้นตอนที่ 3 ใช้รูปแบบเดียวกัน คือเพิ่ม User-agent: Google-Extended ตามด้วย Disallow: / ในไฟล์ robots.txt เดียวกัน โดยเขียนแยกเป็นกลุ่มของตัวเอง ไม่ต้องแตะกลุ่มของ Googlebot เพราะ Google-Extended เป็นโทเค็นควบคุม ไม่ใช่บอทที่เข้าเว็บแยกต่างหาก
แยกบอทฝึก AI ออกจากบอทค้นหา
เจ้าของเว็บที่ยังอยากติดผลค้นหาควรรู้ว่าบริษัท AI แยกบอทตามหน้าที่ OpenAI มี GPTBot สำหรับเก็บเนื้อหาที่อาจใช้ฝึกโมเดล มี OAI-SearchBot สำหรับแสดงเว็บในฟีเจอร์ค้นหาของ ChatGPT และมี ChatGPT-User ที่เข้าหน้าเว็บเมื่อผู้ใช้สั่งให้ไปดู OpenAI ระบุว่าแต่ละบอทควบคุมแยกกัน และ ChatGPT-User ไม่ได้ใช้เก็บข้อมูลอัตโนมัติ แต่กฎ robots.txt อาจไม่ครอบคลุมการเข้าหน้าเว็บที่ผู้ใช้เป็นคนสั่ง ถ้าบล็อก OAI-SearchBot เว็บจะไม่ถูกแสดงเป็นคำตอบในการค้นหาของ ChatGPT แต่ยังอาจขึ้นเป็นลิงก์นำทาง
ฝั่ง Google ใช้โทเค็น Google-Extended ใน robots.txt ตามเอกสารของ Google โทเค็นนี้กำหนดว่าเนื้อหาที่ Google เก็บมาจะใช้ฝึกโมเดล Gemini รุ่นต่อไปได้หรือไม่ และจะส่งเนื้อหาจากดัชนีค้นหาไปให้ Gemini ตอบคำถามได้หรือไม่ Google ยืนยันว่า Google-Extended ไม่กระทบการติดอยู่ในผลค้นหา และไม่ใช้เป็นสัญญาณจัดอันดับ จึงปิดได้โดยไม่ต้องห่วงเรื่องอันดับเว็บ
กันที่ชั้นเครือข่ายด้วย Cloudflare
เมื่อ robots.txt เป็นแค่คำขอร้อง การมีเครื่องมือที่ตั้งกฎกับบอทจริงๆ จึงช่วยเสริมได้ Cloudflare มีเครื่องมือชื่อ AI Crawl Control (เดิมชื่อ AI Audit) ที่มีแดชบอร์ดดูกิจกรรมของบอท AI ตั้งกฎอนุญาตหรือบล็อกเป็นรายบอท และดูได้ว่าบอทตัวไหนทำตามคำสั่งใน robots.txt แล้วสร้างกฎบังคับกับตัวที่ไม่ทำตาม Cloudflare ระบุว่าเครื่องมือนี้ใช้ได้ทุกแผน
เอกสารของ Cloudflare อีกหน้าระบุว่า ทุกแผนตั้งค่าชุดพฤติกรรมสำเร็จรูปสำหรับบอทกลุ่มค้นหา กลุ่มเอเจนต์ และกลุ่มฝึกโมเดลได้ เว็บที่ไม่ได้ใช้ Cloudflare ต้องหาบริการที่ทำหน้าที่คล้ายกันเอง
เฝ้าติดตามว่างานถูกนำไปใช้ที่ไหน
การป้องกันทุกแบบอาจพลาดได้ จึงควรตรวจว่ามีใครคัดลอกงานไปหรือไม่ สำหรับรูปภาพ ใช้ฟีเจอร์ค้นหาด้วยรูปภาพของ Google ได้ ทั้งอัปโหลดไฟล์ วางลิงก์รูป หรือคลิกขวาที่รูปในเบราว์เซอร์ Chrome แล้วเลือกค้นหาด้วย Google Lens ส่วนบทความ Copyscape เป็นบริการตรวจสอบการคัดลอกที่มีเครื่องมือตรวจฟรี และมี Copysentry ที่ตรวจเว็บซ้ำเป็นระยะแล้วแจ้งเจ้าของเว็บเมื่อพบสำเนา
เครื่องมือเหล่านี้ช่วยหาสำเนาบนเว็บได้ แต่ไม่อาจบอกว่าผลงานถูกนำไปฝึกโมเดล AI หรือไม่ ถ้าพบการคัดลอกที่ละเมิดสิทธิ์ ควรเก็บภาพหน้าจอและลิงก์ไว้เป็นหลักฐาน และปรึกษาผู้เชี่ยวชาญด้านกฎหมายลิขสิทธิ์เรื่องแนวทางดำเนินการ
ที่มา: Google Search Central (เอกสารแนะนำ robots.txt, การสร้างไฟล์ robots.txt และรายการบอทของ Google), เอกสารบอทของ OpenAI, เอกสารของ Cloudflare เรื่อง AI Crawl Control และหมวดบอทที่ยืนยันแล้ว, Copyscape, ศูนย์ช่วยเหลือ Google Search เรื่องการค้นหาด้วยรูปภาพ