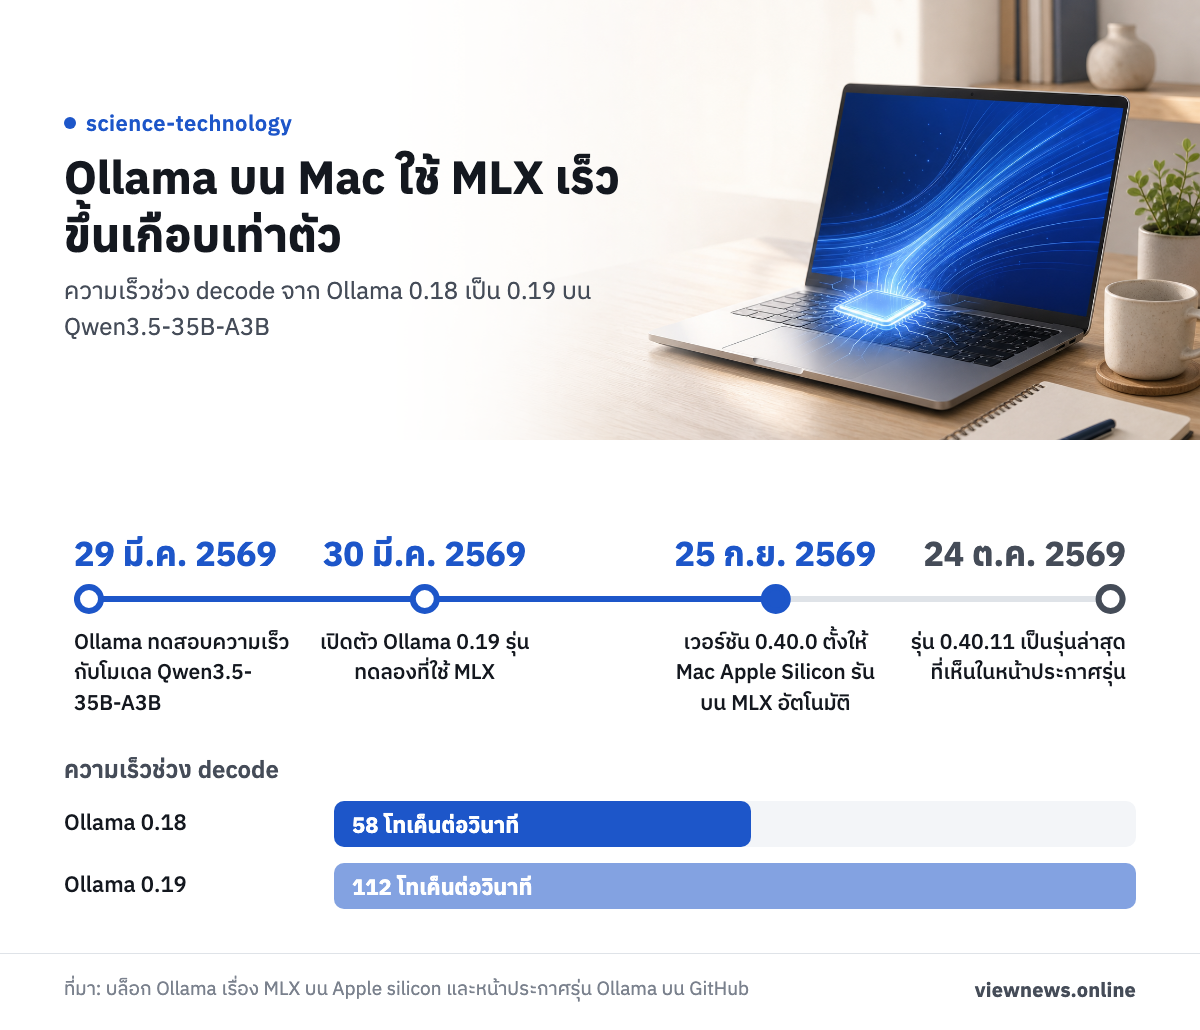
ผู้ใช้ Mac ที่รันโมเดล AI ในเครื่องผ่านโปรแกรม Ollama จะได้ความเร็วเพิ่มขึ้นจากการที่ Ollama หันมาใช้ MLX ซึ่งเป็นเฟรมเวิร์กเรียนรู้ของเครื่อง (machine learning) ของ Apple Ollama เปิดตัวรุ่นทดลองเวอร์ชัน 0.19 เมื่อ 30 มี.ค. 2569 และเวอร์ชัน 0.40.0 เมื่อ 25 ก.ย. 2569 ก็ตั้งให้ Mac ชิป Apple Silicon รันโมเดลที่รองรับบน MLX โดยอัตโนมัติ ผู้ใช้ไม่ต้องตั้งค่าเอง แต่ต้องอัปเดตโปรแกรมและดึงโมเดลที่รองรับ
ตัวเลขความเร็วที่ Ollama วัดได้
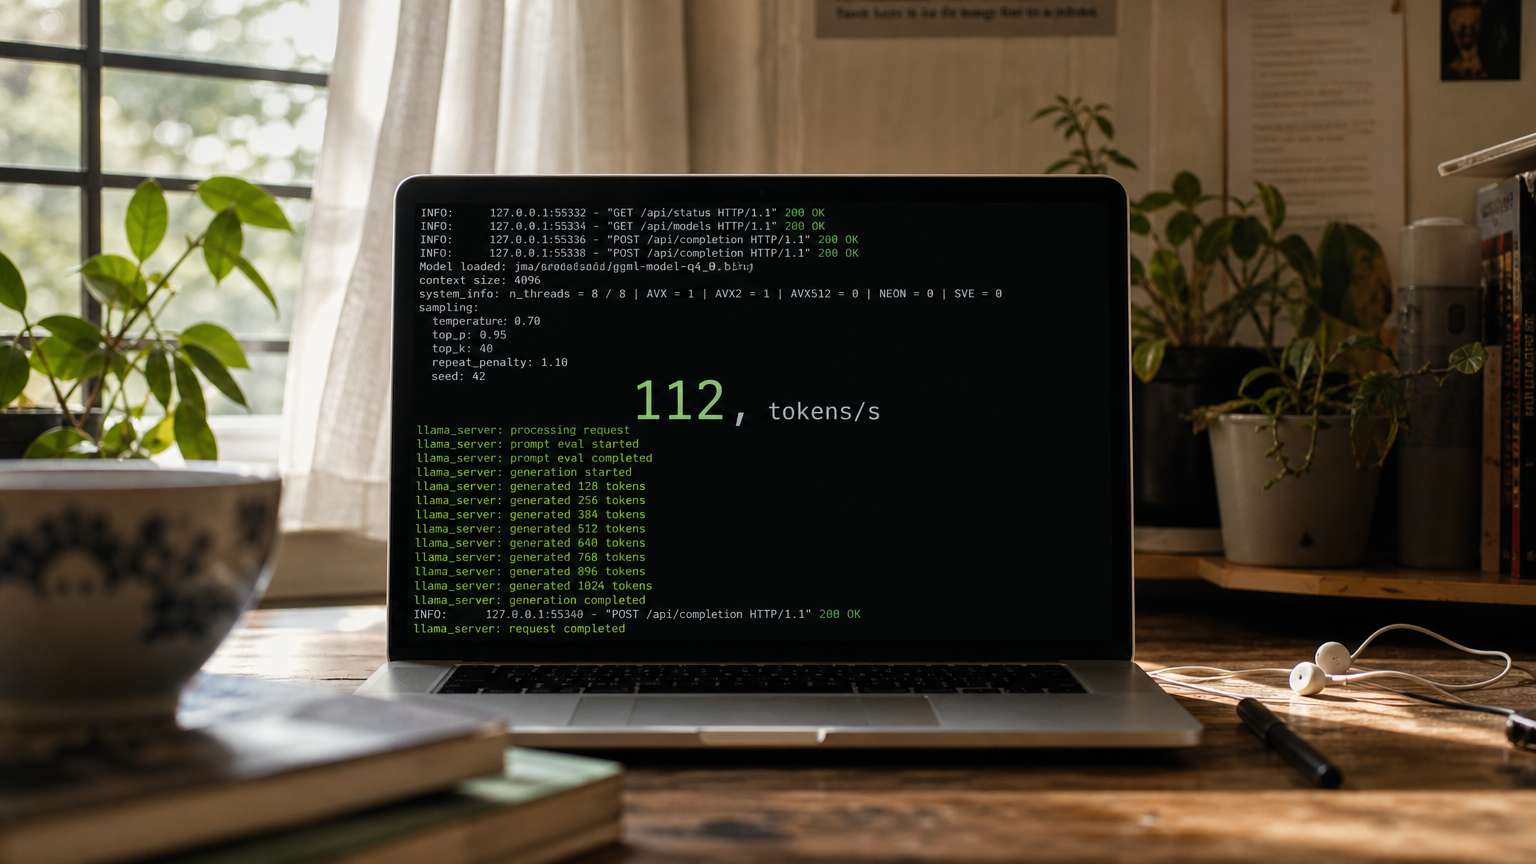
Ollama ทดสอบกับโมเดล Qwen3.5-35B-A3B เมื่อ 29 มี.ค. 2569 และเทียบ Ollama 0.19 กับ 0.18 ผลคือความเร็วช่วง decode (ช่วงสร้างคำตอบออกมา) เพิ่มจาก 58 เป็น 112 โทเค็นต่อวินาที ส่วนช่วง prefill (ช่วงประมวลผลคำสั่งที่ป้อนเข้าไป) เพิ่มจาก 1,154 เป็น 1,810 โทเค็นต่อวินาที
ถ้าใช้การบีบอัดโมเดลแบบ int4 ตัวเลขจะสูงขึ้นอีก คือ prefill 1,851 และ decode 134 โทเค็นต่อวินาที ตามที่ Ollama รายงาน ต้องดูเงื่อนไขการทดสอบประกอบด้วย ตัวเลขของ 0.19 ใช้รูปแบบ NVFP4 ส่วนของ 0.18 ใช้ Q4_K_M ดังนั้นความเร็วที่ผู้ใช้แต่ละคนเจอจะต่างกันตามรุ่นโมเดล รุ่นเครื่อง และขนาดหน่วยความจำ
สำหรับชิป M5, M5 Pro และ M5 Max Ollama ระบุว่าใช้ตัวเร่งแบบ Neural Accelerators ในหน่วยประมวลผลกราฟิก (GPU) ช่วยลดเวลารอคำแรกและเพิ่มความเร็วสร้างคำตอบ ภาพรวมจากตัวเลขข้างต้นคือช่วง decode เร็วขึ้นเกือบเท่าตัว
จากรุ่นทดลองสู่ค่าเริ่มต้นบน Mac
จนถึงรุ่น 0.40.0 ที่ออกเมื่อ 25 ก.ย. 2569 Ollama ประกาศว่าบนอุปกรณ์ Apple Silicon สถาปัตยกรรมโมเดลที่ MLX รองรับจะรันบน MLX โดยอัตโนมัติ รายชื่อที่ระบุในประกาศเดียวกันคือ gemma4, qwen3.6 และ qwen3.5 (ตัวอย่างคำสั่งในประกาศใช้ qwen3.8) รวมถึงโมเดลตระกูล decision อย่าง Nimble, tev1, clef และ clef-flash และโมเดลฝังข้อความ embeddinggemma-2 Ollama บอกว่าจะทดสอบและเปิดรองรับโมเดลเพิ่มต่อไป
รุ่นย่อยหลังจากนั้นขยายรายการต่อ ตามหน้าประกาศรุ่นของ Ollama รุ่น 0.40.4 เพิ่มการรองรับโมเดล decision บน Apple Silicon และรุ่น 0.40.8 เพิ่มโมเดล Flint บน macOS รุ่นล่าสุดที่เห็นในหน้าเดียวกันคือ 0.40.11 เมื่อ 24 ต.ค. 2569 ซึ่งเพิ่มความสามารถสร้างเสียงพูดบน macOS
ช่วงรุ่นทดลอง Ollama เคยเปิดให้ใช้ MLX กับโมเดลเดียวคือ Qwen3.5-35B-A3B ที่ปรับค่าสุ่มคำตอบให้เหมาะกับงานเขียนโค้ด และแนะนำให้ใช้ Mac ที่มีหน่วยความจำรวม (unified memory) มากกว่า 32GB ประกาศรุ่น 0.40.0 ไม่ได้ระบุเกณฑ์หน่วยความจำ ผู้ใช้ที่มีแรมน้อยกว่านั้นจึงควรลองกับโมเดลขนาดเล็กลงและดูผลเอง
เครื่องแบบไหนได้ใช้ และต้องทำอะไร
เครื่องที่เข้าข่ายคือ Mac ชิป Apple Silicon ซึ่ง Ollama ระบุเป็นเป้าหมายของการเปลี่ยนมาใช้ MLX Ollama ไม่ได้กำหนดชื่อรุ่นชิปขั้นต่ำไว้ในประกาศที่เปิดอ่านได้ ยกเว้นข้อมูลว่า M5 ได้ตัวเร่งเพิ่มเติม สิ่งที่ต้องทำมีดังนี้
- อัปเดต Ollama เป็นเวอร์ชันล่าสุด โปรแกรมโหลดอัปเดตอัตโนมัติ ให้กดไอคอนบนแถบเมนูแล้วเลือก 'Restart to update' หรือดาวน์โหลดจากหน้า ollama.com/download
- ดึงโมเดลที่รองรับ เช่น พิมพ์ ollama pull qwen3.8 แล้ว ollama run qwen3.8 ตามตัวอย่างในประกาศรุ่น 0.40.0
- ถ้าอยากลองคำสั่งจากรุ่นทดลอง Ollama ให้ตัวอย่าง ollama run qwen3.5:35b-a3b-coding-nvfp4
ขนาดไฟล์โมเดลขึ้นกับโมเดลที่เลือก จึงควรดูขนาดบนหน้าโมเดลของ Ollama ก่อนดาวน์โหลด เพื่อให้แน่ใจว่าพื้นที่ว่างในเครื่องพอ
ข้อควรรู้ก่อนคาดหวัง
Ollama ระบุว่า MLX ออกแบบมาให้ใช้ประโยชน์จากสถาปัตยกรรมหน่วยความจำรวมของ Apple Silicon และรุ่น 0.19 ปรับการเก็บแคชข้อความให้ใช้ซ้ำข้ามบทสนทนาได้ ช่วยลดการใช้หน่วยความจำและลดการประมวลผลคำสั่งซ้ำเมื่อใช้ system prompt ชุดเดิม Ollama ยังไม่ได้เผยแพร่ตัวเลขการใช้พลังงานหรืออุณหภูมิของเครื่องเมื่อใช้ MLX จึงยังเทียบด้านนี้ไม่ได้
ผู้ใช้ที่ต้องการทำงานกับโมเดลของตัวเองต้องรอดูต่อ Ollama ระบุในประกาศรุ่นทดลองว่าจะเพิ่มวิธีนำเข้าโมเดลที่ปรับแต่งเองบนสถาปัตยกรรมที่รองรับ และจะขยายรายการสถาปัตยกรรม ส่วนโมเดลที่ MLX ยังไม่รองรับ ประกาศไม่ได้อธิบายว่าจะทำงานอย่างไร ควรตรวจรายการโมเดลที่รองรับในหน้าประกาศรุ่นล่าสุดเป็นระยะ
ผู้ใช้ Apple Silicon ที่ใช้ Ollama อยู่แล้วอัปเดตโปรแกรมและลองโมเดลที่รองรับได้เลย แล้วเทียบความเร็วกับที่เคยใช้ก่อนหน้า
ที่มา: บล็อก Ollama เรื่อง MLX บน Apple silicon (30 มี.ค. 2569), หน้าประกาศรุ่น Ollama บน GitHub (รุ่น 0.40.0 ถึง 0.40.11) และเอกสารคำถามที่พบบ่อยของ Ollama