Qwen3 คือโมเดลปัญญาประดิษฐ์ (AI) ภาษาขนาดใหญ่ชุดหนึ่งที่ทีม Qwen เปิดตัวเมื่อ 29 เม.ย. 2568 ให้นักพัฒนา นักวิจัย และธุรกิจดาวน์โหลดโมเดลไปใช้ได้ฟรี ชุดนี้มี 8 รุ่น ตั้งแต่รุ่นเล็กที่รันบนเครื่องส่วนตัวได้ไปจนถึงรุ่นใหญ่ระดับ 235,000 ล้านพารามิเตอร์ (ตัวเลขที่บอกขนาดของโมเดล) ทีม Qwen ระบุว่าโมเดลรองรับ 119 ภาษาและภาษาถิ่น และเปิดน้ำหนักโมเดลภายใต้สัญญาอนุญาต Apache 2.0 ซึ่งเป็นสัญญาที่เปิดทางให้นำไปใช้ต่อได้อย่างกว้าง
ก่อนเลือกรุ่นไปใช้ ควรรู้ว่าแต่ละรุ่นมีขนาดและความสามารถต่างกัน ทั้งจำนวนพารามิเตอร์ ความยาวบริบทที่อ่านได้ และวิธีเรียกใช้งาน ซึ่งเป็นสิ่งที่กำหนดว่ารุ่นไหนเหมาะกับเครื่องและงานของผู้ใช้
Qwen3 มีกี่รุ่น ต่างกันอย่างไร
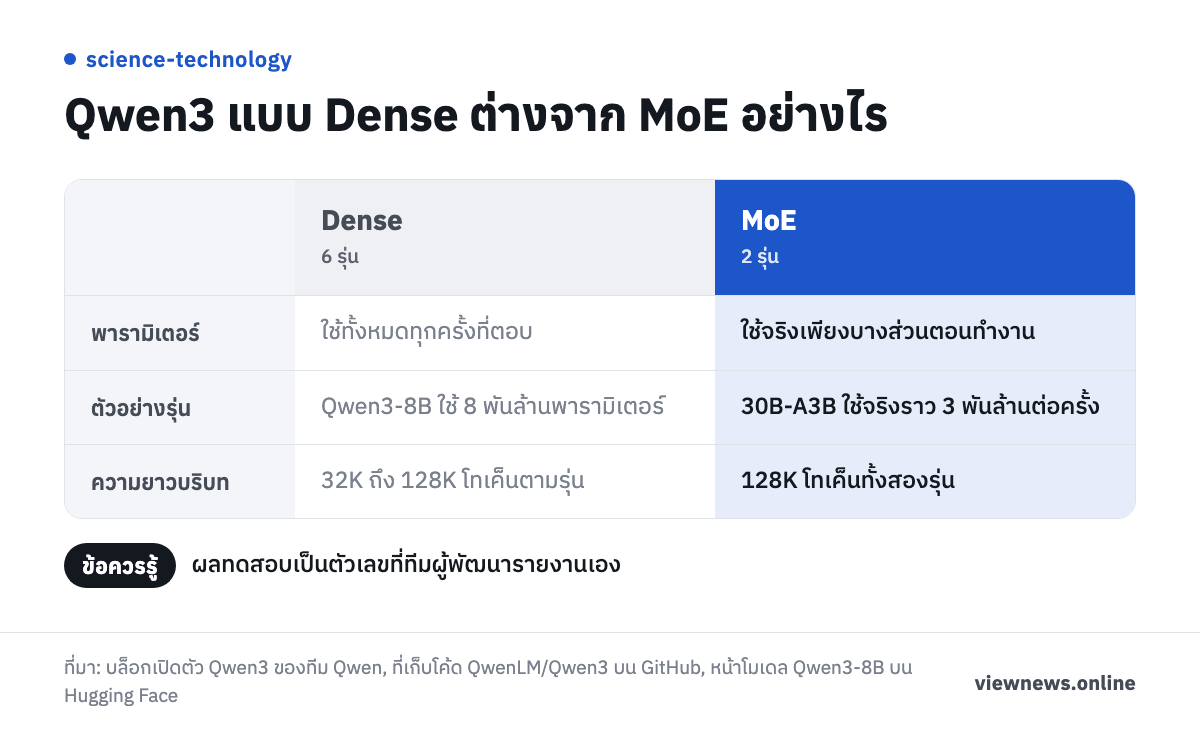
ตามบล็อกเปิดตัวของทีม Qwen โมเดลชุดแรกมี 8 รุ่น แบ่งเป็นสองตระกูล ตระกูลแรกคือโมเดลแบบ Dense หรือโมเดลที่ใช้พารามิเตอร์ทั้งหมดทุกครั้งที่ตอบ มี 6 รุ่น ได้แก่ Qwen3-0.6B, Qwen3-1.7B, Qwen3-4B, Qwen3-8B, Qwen3-14B และ Qwen3-32B ตัวเลขหน้าตัว B คือจำนวนพารามิเตอร์เป็นพันล้าน เช่น 8B คือ 8 พันล้านพารามิเตอร์
ตระกูลที่สองคือโมเดลแบบ MoE (Mixture-of-Experts) มี 2 รุ่น คือ Qwen3-30B-A3B และ Qwen3-235B-A22B ชื่อรุ่นบอกขนาดสองค่า ค่าแรกคือพารามิเตอร์ทั้งหมด ค่าหลังตัว A คือจำนวนที่ถูกเรียกใช้จริงตอนทำงาน เช่น รุ่น 30B-A3B มีทั้งหมด 30 พันล้าน แต่ใช้งานจริงราว 3 พันล้านต่อครั้ง ข้อนี้เป็นที่มาของคำอธิบายเรื่องต้นทุนต่ำ เพราะทีม Qwen ระบุว่าโมเดลฐานแบบ MoE ให้ผลใกล้เคียงโมเดลฐาน Dense ของ Qwen2.5 โดยใช้พารามิเตอร์ที่ทำงานจริงเพียง 10%
ความยาวบริบท หรือปริมาณข้อความที่โมเดลอ่านได้ในครั้งเดียว ต่างกันตามขนาด รุ่น 0.6B, 1.7B และ 4B รองรับ 32K โทเค็น ส่วนรุ่น 8B, 14B, 32B, 30B-A3B และ 235B-A22B รองรับ 128K โทเค็น หน้าโมเดลของรุ่น 8B บน Hugging Face ระบุว่าโมเดลรองรับ 32,768 โทเค็นโดยตรง และขยายได้ถึง 131,072 โทเค็นด้วยเทคนิค YaRN
ในแง่การเลือกใช้ รุ่นเล็กอย่าง 0.6B และ 1.7B เหมาะกับงานที่ต้องการให้โมเดลเบาและทำงานบนอุปกรณ์จำกัด ส่วนรุ่นใหญ่อย่าง 235B-A22B เป็นรุ่นที่ทีม Qwen นำไปเทียบผลทดสอบกับโมเดลชั้นนำ ทีมระบุว่า Qwen3-235B-A22B ให้ผลที่แข่งขันได้ในการทดสอบด้านเขียนโค้ด คณิตศาสตร์ และความสามารถทั่วไป เมื่อเทียบกับ DeepSeek-R1, o1, o3-mini, Grok-3 และ Gemini-2.5-Pro ส่วนรุ่นกลางก็มีผลทดสอบที่ทีมเน้น เช่น Qwen3-30B-A3B ทำผลได้ดีกว่า QwQ-32B ทั้งที่ใช้พารามิเตอร์ที่ทำงานจริงราวหนึ่งในสิบ และ Qwen3-4B ถูกระบุว่าสู้ Qwen2.5-72B-Instruct ได้
ตัวเลขทั้งหมดนี้เป็นผลทดสอบที่ทีมผู้พัฒนารายงานเอง ผู้ที่จะนำไปใช้ในธุรกิจจึงควรทดสอบกับงานจริงของตัวเองก่อน โดยเฉพาะงานภาษาไทยที่คุณภาพอาจต่างจากผลทดสอบรวม
เปิดน้ำหนักให้ใช้ฟรีภายใต้ Apache 2.0 ดาวน์โหลดได้จากหลายแหล่ง
หน้า GitHub ของ Qwen3 ระบุว่าโมเดลแบบเปิดน้ำหนักทั้งหมดของทีมใช้สัญญาอนุญาต Apache 2.0 โมเดลทั้งแบบที่ผ่านการปรับแต่งหลังฝึก (post-trained) และแบบฐาน (pre-trained) ดาวน์โหลดได้จาก Hugging Face, ModelScope และ Kaggle ส่วนโค้ดและวิธีใช้อยู่ในที่เก็บโค้ดบน GitHub ของ QwenLM
คำว่าเปิดน้ำหนัก (open-weight) หมายถึงทีมปล่อยตัวโมเดลที่ฝึกเสร็จแล้วให้ดาวน์โหลดไปรันเอง ผู้ใช้จึงไม่ต้องเรียกผ่านบริการคลาวด์ของผู้พัฒนาเท่านั้น หน้า GitHub ระบุเครื่องมือที่ใช้รันได้หลายแบบ เช่น Transformers (ต้องเป็นรุ่น 4.51.0 ขึ้นไป) llama.cpp Ollama LM Studio และ MLX LM ส่วนการเปิดเป็นบริการสำหรับหลายผู้ใช้ทำได้ผ่าน SGLang, vLLM และ TensorRT-LLM ซึ่งให้ API ที่เข้ากันได้กับรูปแบบของ OpenAI
ทีม Qwen ระบุว่าฝึกโมเดลด้วยข้อมูลราว 36 ล้านล้านโทเค็น เกือบสองเท่าของ Qwen2.5 ที่ใช้ 18 ล้านล้านโทเค็น และข้อมูลครอบคลุม 119 ภาษาและภาษาถิ่น หน้า GitHub และหน้าโมเดลบน Hugging Face เขียนจำนวนภาษาเป็น 100 กว่าภาษา ซึ่งไม่ขัดกับตัวเลข 119 ในบล็อกเปิดตัว
โหมดคิดลึกกับโหมดตอบเร็วในโมเดลเดียว
จุดเด่นอีกข้อของ Qwen3 คือโมเดลสลับได้ระหว่างโหมดคิด (thinking) ที่ให้โมเดลไล่เหตุผลทีละขั้นก่อนตอบ กับโหมดไม่คิด (non-thinking) ที่ตอบเร็วกว่า ทีม Qwen อธิบายว่าโหมดคิดเหมาะกับโจทย์ซับซ้อน เช่น คณิตศาสตร์และการเขียนโค้ด ส่วนโหมดตอบเร็วเหมาะกับการสนทนาทั่วไป
การสลับทำได้สองทาง ทางแรกคือตั้งค่า enable_thinking ตอนเรียกใช้โมเดล ถ้าตั้งเป็น False โมเดลจะปิดการคิดทั้งหมด ทางที่สองคือพิมพ์คำสั่ง /think หรือ /no_think ต่อท้ายข้อความในแต่ละรอบสนทนา หน้าโมเดลรุ่น 8B ระบุว่าโมเดลเปิดโหมดคิดไว้เป็นค่าเริ่มต้น และคำสั่งสลับในข้อความจะไม่มีผลถ้าปิดโหมดคิดไว้ตั้งแต่ต้น
ข้อดีของการรวมสองโหมดไว้ในโมเดลเดียวคือผู้ใช้ไม่ต้องแยกใช้โมเดลสองตัวสำหรับงานสองแบบ งานง่ายใช้โหมดตอบเร็วเพื่อประหยัดเวลา งานยากค่อยเปิดโหมดคิด
ความเคลื่อนไหวหลังเปิดตัว
หลังเปิดตัวชุดแรก ทีม Qwen ออกโมเดลรุ่นปรับปรุงที่ใช้ชื่อต่อท้ายว่า 2507 ตามบันทึกบน GitHub เริ่มจาก Qwen3-235B-A22B-Instruct-2507 เมื่อ 21 ก.ค. 2568 และ Qwen3-235B-A22B-Thinking-2507 ตามมาในปลายเดือนเดียวกัน ก่อนจะออกรุ่น 30B-A3B และ 4B ต่อในช่วงปลายเดือน ก.ค. ถึงต้นเดือน ส.ค.
รุ่น 2507 แยกเป็นสองสาย สาย Instruct ตอบแบบไม่คิด ส่วนสาย Thinking คิดอย่างเดียว ไม่มีการสลับโหมดในโมเดลเดียวเหมือนชุดแรก ทีมยังประกาศเมื่อ 8 ส.ค. 2568 ว่ารุ่น 2507 รองรับอินพุตได้ถึง 1 ล้านโทเค็น ผู้ที่จะเลือกใช้ Qwen3 จึงควรเปิดดูหน้าที่เก็บโค้ดบน GitHub เพื่อตรวจรายการรุ่นล่าสุดก่อนดาวน์โหลด
ที่มา: บล็อกเปิดตัว Qwen3 ของทีม Qwen (qwenlm.github.io), ที่เก็บโค้ด QwenLM/Qwen3 บน GitHub, หน้าโมเดล Qwen3-8B บน Hugging Face